10 étapes pour développer des compétences en IA en généalogie :
Étape 2 Maîtriser la communication de base avec l’IA
Tips for Genealogists using AI tools to assist them in their ancestral archival and storytelling projects.
Subscribe now for more insightful lessons on leveraging AI in genealogy. Let's embark on this transformative journey together, unveiling the stories of our ancestors with the latest in AI technology.
Résumé : 10 étapes pour développer des compétences en IA dans la généalogie – Étape 2 : Maîtriser la communication de base avec l’IA
Introduction à la communication avec l'IA (00:03–01:06) :
Considérez l’IA comme un assistant de recherche compétent nécessitant des instructions claires et spécifiques.
Apprenez à utiliser des outils d’IA, comme ChatGPT ou Claude, pour vos recherches en histoire familiale.
Développez des techniques pour rédiger des prompts efficaces et obtenir des réponses utiles.
Les quatre éléments clés des prompts efficaces (02:01–03:57) :
Contexte : Définissez qui vous êtes, votre sujet de recherche, et ce que vous avez déjà exploré (par exemple : « Je suis un généalogiste recherchant des ancêtres du 19e siècle en Irlande »).
Objectif spécifique : Décomposez vos objectifs en résultats clairs, comme trouver des registres précis ou des événements historiques.
Contraintes : Mentionnez les périodes, lieux, ou limitations (par exemple : « Les registres paroissiaux catholiques ont été détruits à cette époque »).
Détails pertinents : Fournissez des faits connus, des relations familiales, et des informations sur le contexte historique.
Structuration des prompts (04:51–05:46) :
Exemple : « Je recherche mon ancêtre Patrick O’Brien, né vers 1855 dans le comté de Cork. J’ai vérifié les registres paroissiaux et civils sans succès. Pouvez-vous suggérer des types de documents alternatifs, des variations de nom, et des événements historiques influençant la disponibilité des registres ? »
Utilisation des questions de suivi (05:46–06:37) :
Approfondissez les réponses de l’IA avec des questions complémentaires, par exemple : « Quels archives consulter pour ces types de documents ? »
Tenez un journal des prompts réussis pour les réutiliser.
Erreurs fréquentes à éviter (06:37–08:30) :
Être trop vague : Ajoutez des détails (par exemple : dates, lieux).
Surcharger les prompts : Concentrez-vous sur un objectif spécifique au lieu de demander des informations exhaustives.
Négliger le contexte : Fournissez des informations de base pour guider les réponses de l’IA.
Activités pratiques (08:30–10:07) :
Exercice 1 : Rédigez un prompt de recherche généalogique en utilisant les quatre éléments clés.
Exemple : Recherchez les documents de migration pour Timothy Dwan (1839–1865) du comté de Tipperary à l’Australie, en vous concentrant sur les registres paroissiaux et les listes de passagers.
Démonstration avec Claude (10:07–14:36) :
Analyse et amélioration des prompts grâce à Claude, incluant une expansion du contexte (ex. : migration liée à la Grande Famine) et des suggestions détaillées pour des types de documents et des ressources spécifiques.
Claude a suggéré des sources comme des listes de passagers, des programmes d'immigration victorienne, et des registres d'expédition.
Points clés à retenir (14:36–15:33) :
Soyez spécifique et structuré dans vos prompts.
Fournissez un contexte et des contraintes pertinents.
Utilisez des questions de suivi pour affiner votre recherche.
Maintenez des modèles et des journaux pour assurer une cohérence.
Étapes suivantes (15:33–fin) :
Rédigez au moins trois prompts en vous exerçant.
Partagez vos prompts pour obtenir des retours.
Préparez-vous pour la prochaine leçon sur la planification des recherches.
Après mes découvertes de la semaine dernière que ChatGPT (modèle GPT-4) peut : (1) créer, lire et interpréter correctement des fichiers GEDCOM, (2) créer des rapports narratifs basés uniquement sur les données GEDCOM, (3) faire correspondre le style narratif à l’emplacement et au cadre du texte, et (4) générer des numéros de notes de référence en exposant en ligne et fournir leurs notes de référence correspondantes ou citations de sources en notes de fin à partir de sources GEDCOM, J’étais intéressé de savoir à partir de quelles autres sources ChatGPT pourrait extraire des informations généalogiques.
Ainsi, en attendant le traitement visuel des enregistrements, qui transformera un dossier de certificats de naissance, de mariage et de décès en arbres généalogiques sourcés, je me suis concentré sur l’apprentissage de l’utilisation des outils d’IA pour extraire chaque goutte d’informations généalogiques à partir de sources textuelles, telles que les nécrologies, les annonces de fiançailles et de mariage, et les articles de journaux, et sur la collecte de ces informations provenant dans des formats ordonnés et utiles. tels que des feuilles de calcul (fichiers CSV), des arbres généalogiques (fichiers GEDCOM), des fichiers JSON et d’autres formats utiles.
Aider les gens à trouver l’information dont ils ont besoin dans les textes est une passion depuis 30 ans. J’ai suivi une formation pour ce travail lors d’une première carrière en technologie de l’information dans des bibliothèques de droit, d’université et d’archives. Mon dernier emploi dans ce domaine a été celui d’archiviste numérique pour la Bibliothèque de Virginie, aidant les bibliothèques locales à préserver, archiver, cataloguer et publier en ligne leurs collections de photographies. Et avant ce travail, j’ai fait des études supérieures en linguistique appliquée. Alors que mes camarades de classe étudiaient pour devenir professeurs d’anglais, je m’intéressais à la linguistique informatique et au traitement du langage naturel. Un intérêt de trois décennies pour les expressions régulières (programmation sophistiquée de recherche et de remplacement) a été sa propre récompense.
Mais maintenant, ces compétences avancées ne sont plus nécessaires pour utiliser ChatGPT pour extraire des informations généalogiques utiles à partir de nécrologies, d’annonces de naissance, de fiançailles, de mariage ou d’articles de journaux. Désormais, tout le monde, avec un PROMPT réfléchi exprimé en langage simple et naturel, peut rapidement rassembler et récolter des informations provenant de sources pour en faire des collections utiles. Cet article présente au lecteur trois exemples d’utilisation de ChatGPT pour extraire et glaner des informations à partir de trois textes (une nécrologie, une annonce de fiançailles/mariage et un article de journal généalogiquement riche), enregistrer les informations dans des formats utiles appropriés et créer et stocker des citations de sources avec les informations.
Le premier exemple est une nécrologie, souvent un texte généalogiquement riche. C’est le processus que j’ai utilisé pour glaner des informations (personnes, relations, événements, lieux) à partir de la nécrologie et pour stocker les informations, avec citation de la source, dans divers formats. La nécrologie a été écrite par un ami et publiée dans le Washington Post après la mort le 2 mars 2023 de Theodore S. Kanamine, le premier général en service actif américano-japonais de l’armée américaine. Certaines IA sont capables d’extraire et de résumer des informations à partir d’une URL (adresse web), mais pour cet exemple, j’utiliserai ChatGPT (modèle GPT-4), qui actuellement (du moins pour le moment) ne permet que la saisie de texte. Cela signifie que je vais copier-coller le texte de la nécrologie dans la boîte de dialogue de discussion. Mais l’IA doit d’abord recevoir des instructions, appelées PROMPT, des instructions en langage naturel que vous souhaitez que l’IA suive.
Voici le premier PROMPT que j’ai utilisé :
PROMPT: Assume the role of an expert, professional genealogist. Consider the genealogically relevant information that might appear in an obituary. Below is the text of an obituary. I would like to know about the stated relationships between people in the text. When you can with certainty, state the relationship between two people in the article. Present the information in two formats. First, In a markdown table use the form PERSON ONE : PERSON TWO : RELATIONSHIP : INFORMATION. (Where INFORMATION is the quoted text in the article describing the relationship between the two people.) Second, create a GEDCOM file for the named people in the text; include source information in the GEDCOM file.
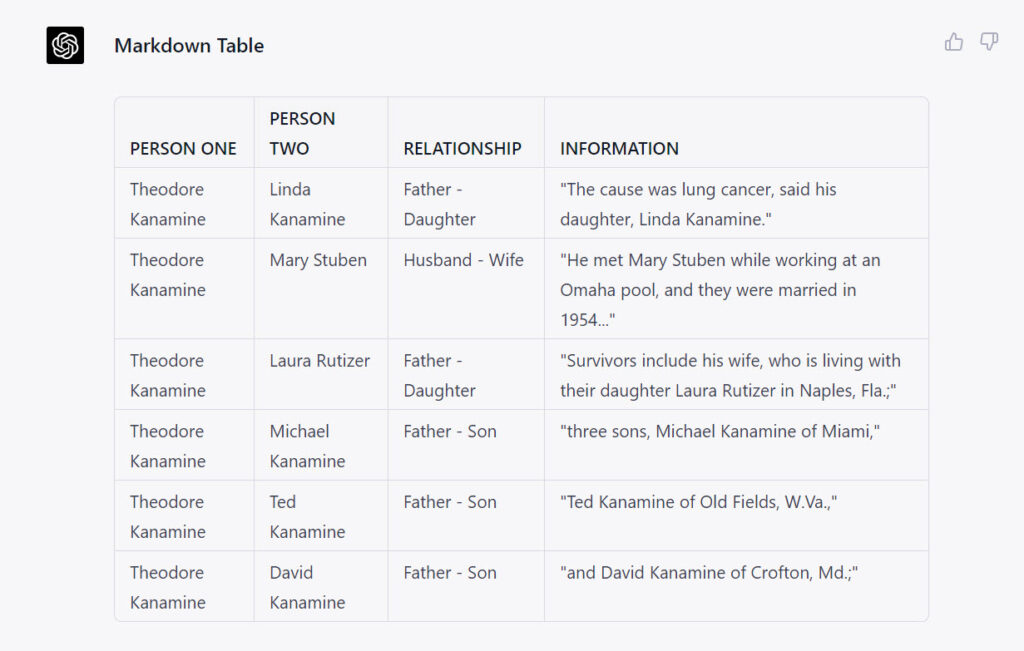
Sous l’INVITE, j’ai collé le texte de la nécrologie. Voici le premier tableau d’informations que ChatGPT a rapidement renvoyé :
Notez que ChatGPT a inclus avec cette INVITE une citation qu’il avait utilisée pour déterminer une relation ; cela permet au chercheur de vérifier l’affirmation de l’IA.
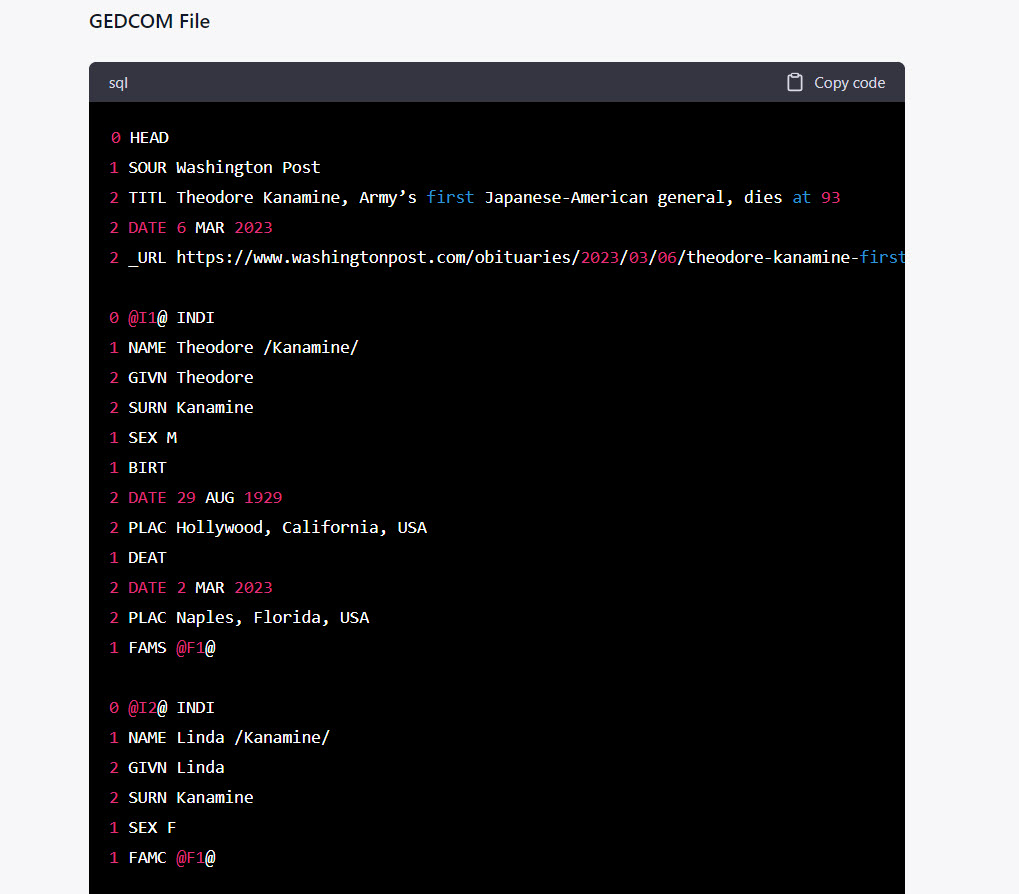
ChatGPT a également été en mesure de générer rapidement un arbre généalogique fonctionnel et sourcé (fichier GEDCOM) à partir de la nécrologie, comme on le voit ici. Notez que les informations sur la source sont incluses dans le fichier. En cliquant sur le bouton « Copier le code » dans le coin supérieur droit de la boîte de dialogue, le texte du GEDCOM peut être rapidement copié et collé dans un éditeur de texte, enregistré avec l’extension *.ged, et ouvert ou importé dans n’importe quelle application de généalogie telle que RootsMagic ou Family Tree Maker.
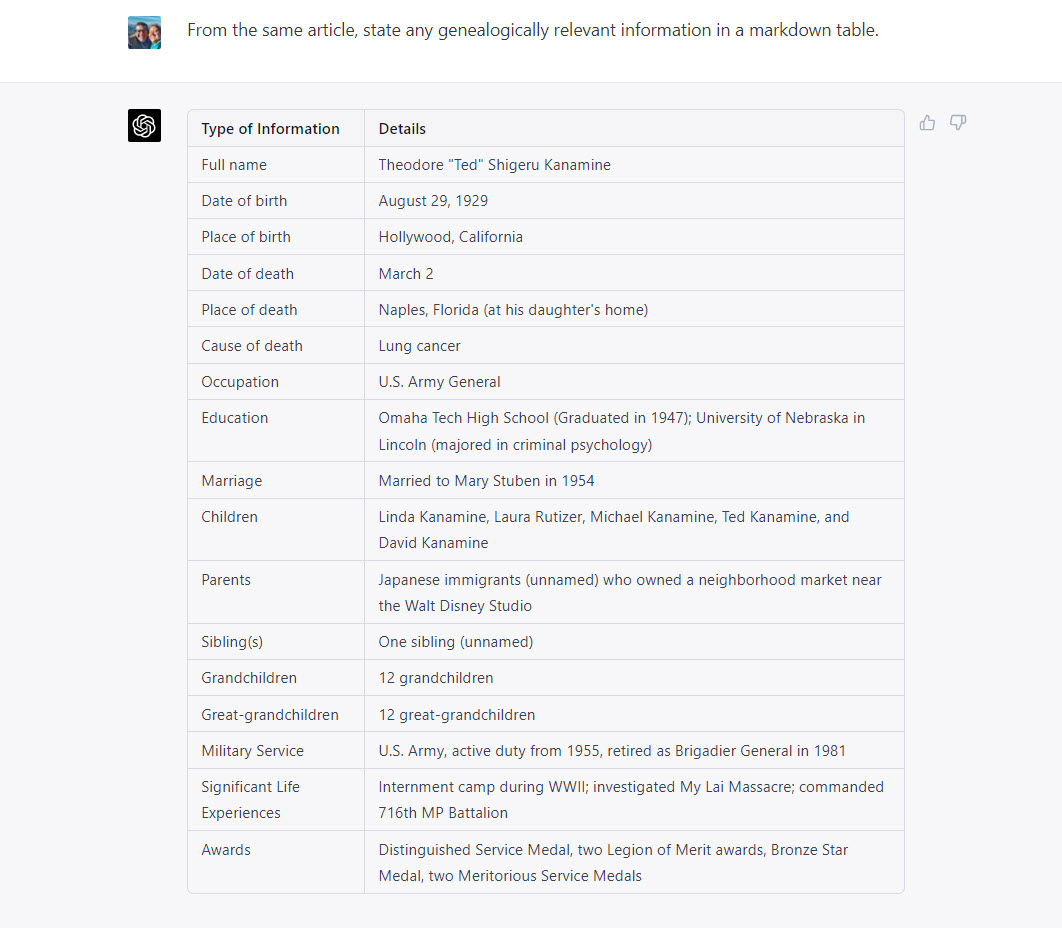
Les relations familiales ne sont pas les seules informations incluses dans les nécrologies. Souvent, les nécrologies contiennent d’autres informations généalogiquement utiles. J’ai donc demandé à ChatGPT de glaner d’autres informations, ce qui a produit ce tableau :
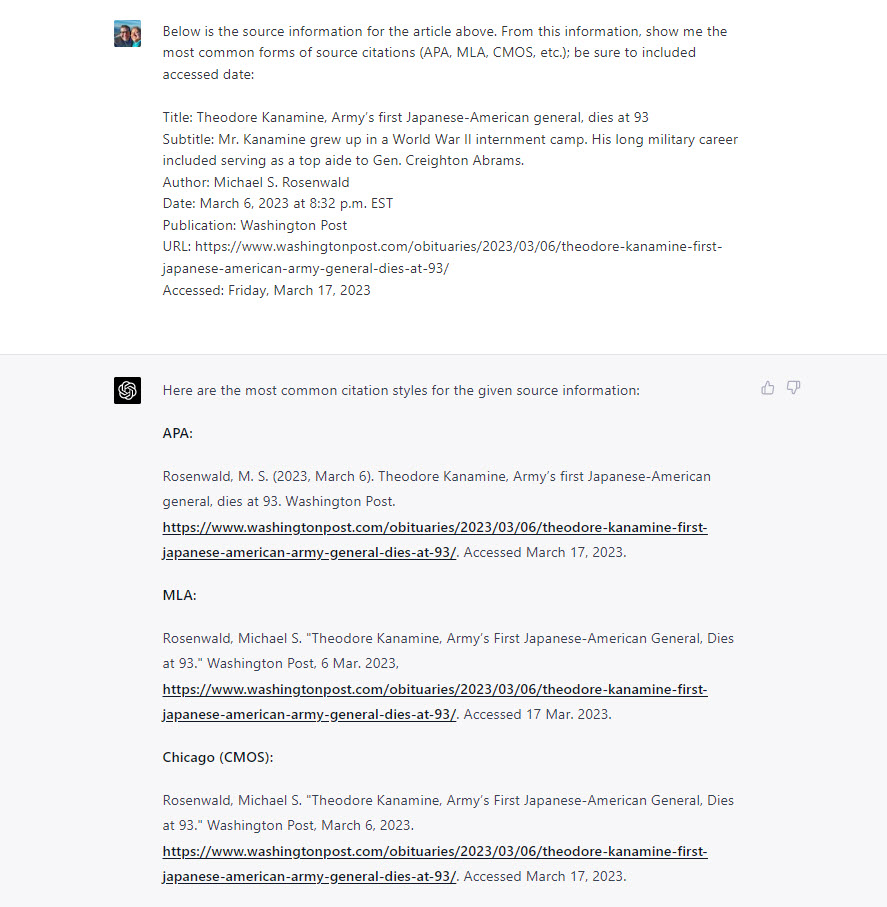
De plus, ChatGPT a été utile pour créer une citation. Au début, j’ai oublié d’inclure les informations sur la date d’accès. Et puis, même lorsque j’ai inclus une date d’accès, ChatGPT ne l’a PAS initialement incluse dans ses citations, mais, lorsqu’à ma troisième tentative, j’ai explicitement demandé à ChatGPT d’inclure la date d’accès, il l’a fait :
CONSEIL DE PRO : Dans le travail de l’IA en généalogie, démarrez de nouvelles sessions de chat ou conversations avant de commencer à travailler avec un nouveau texte ou un nouvel article. Les chatbots fonctionnent en retraitant vos énoncés de conversation précédents. Vous pouvez contaminer les parties ultérieures d’une conversation avec des invites et des entrées antérieures.
Steve Little
Les nécrologies ne sont pas la seule source d’information généalogique que l’on peut trouver dans les journaux. Souvent, les faire-part de naissance, de fiançailles et de mariage sont riches en informations. ChatGPT peut rapidement présenter des informations trouvées dans ce type de textes. L’exemple suivant implique une annonce de mariage plus longue. Démarrez de nouvelles sessions de chat ou conversations avant de commencer à travailler sur un nouveau texte ou un nouvel article. Les chatbots fonctionnent en retraitant vos énoncés de conversation précédents. Vous pouvez contaminer les parties ultérieures d’une conversation avec des invites et des entrées antérieures.
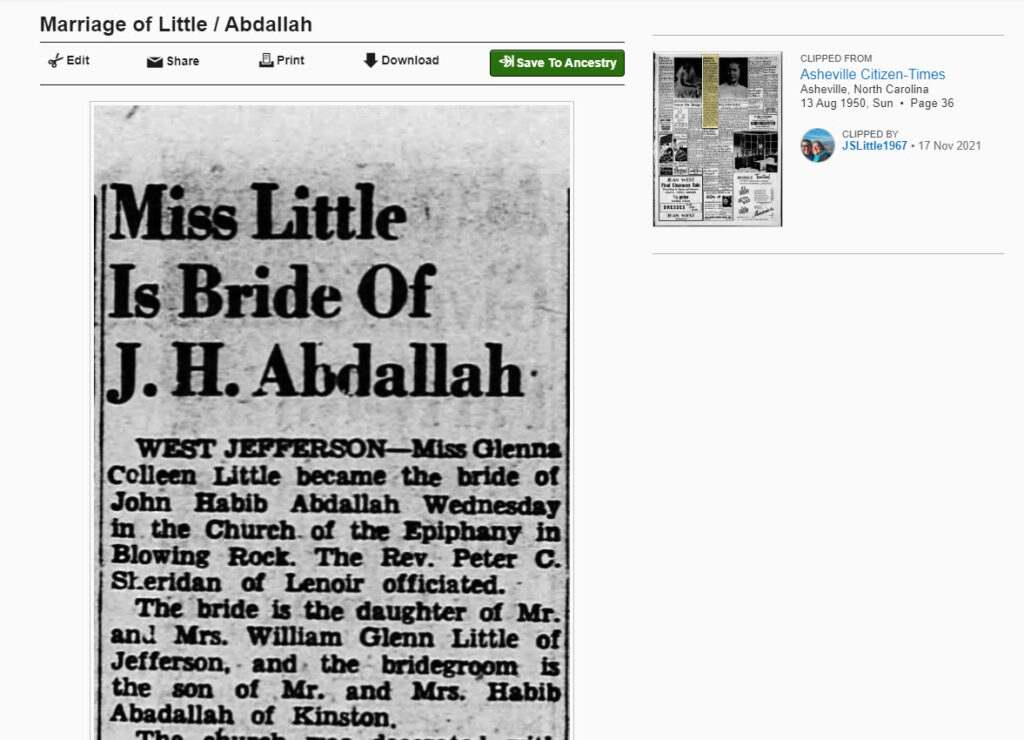
Après avoir prêté attention à démarrer une nouvelle session de chat, mon message pour l’annonce du mariage était presque identique à celui de la nécrologie, mais légèrement reformulé. Le texte d’entrée de l’annonce a été fourni par le fournisseur des archives du journal ; la plupart des fournisseurs fournissent un lien vers le texte OCR qui rend les articles consultables.
PROMPT: Assume the role of an expert, professional genealogist. Consider the genealogically relevant information that might appear in a wedding announcement. Below is the OCR text (correct for spelling) of an announcement. I would like to know about the stated relationships between people in the text. When you can with certainty, state the relationship between two people in the article. Present the information in two formats. First, In a markdown table use the form PERSON ONE : PERSON TWO : RELATIONSHIP : INFORMATION. (Where INFORMATION is the quoted text in the article describing the relationship between the two people.) Second, create a GEDCOM file for the named people in the text; include source information in the GEDCOM file.
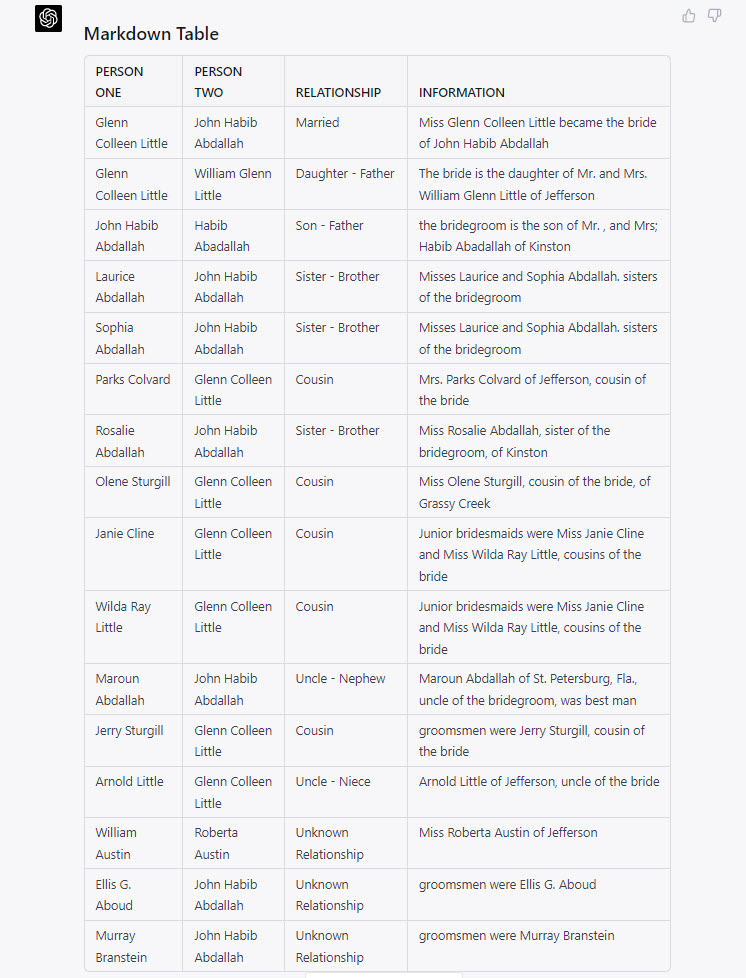
Encore une fois, ChatGPT a rapidement réagi avec un tableau des relations entre les personnes :
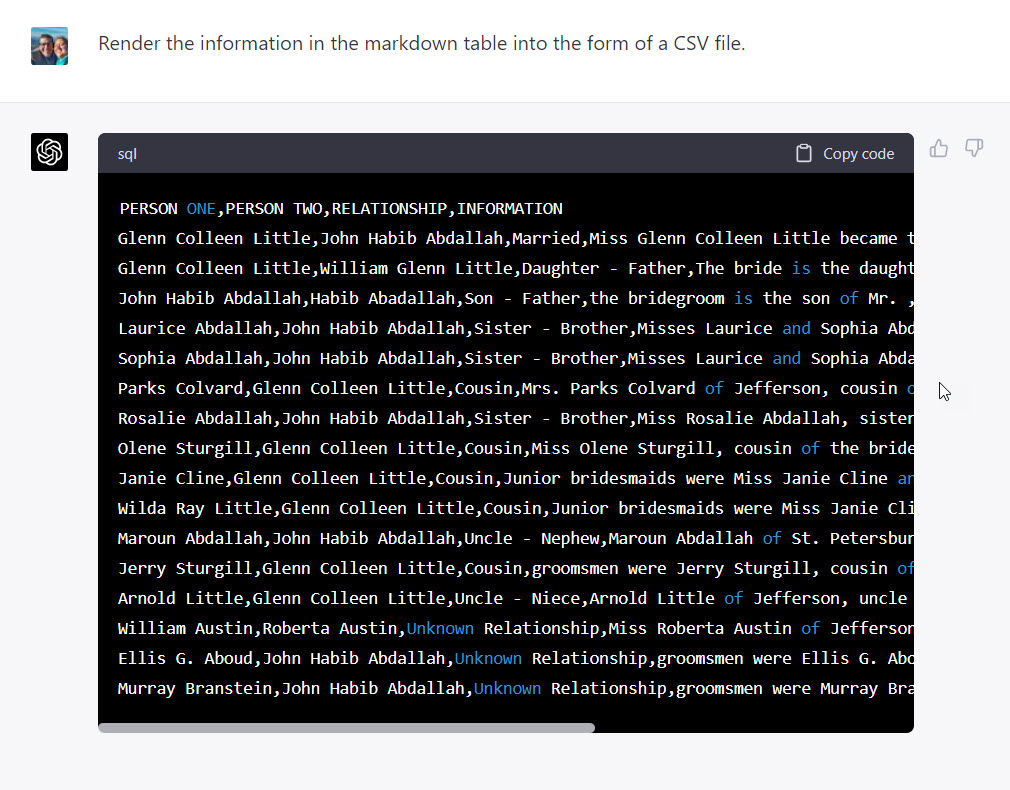
Cette invite a également produit un fichier d’arbre généalogique fonctionnel (GEDCOM), mais comme nous en avons déjà vu un exemple, j’ai demandé à ChatGPT de rendre les informations de la table markdown dans un format qui pourrait être rapidement importé dans une feuille de calcul (comme Excel ou Google Sheets) ou une base de données (comme Airtable ou MySQL), un fichier CSV ou « valeurs séparées par des virgules ».
Sauvegardées avec une extension *.csv telle que « LITTLE-Abdallah wedding.csv », les informations ont pu être rapidement importées dans de nombreuses autres applications.
Notre prochain exemple utilise un texte beaucoup plus long et plus complexe.
[NOTE LINGUISTIQUE : Cette section comprend des discussions et un langage liés aux relations entre les descendants des esclaves et leurs esclavagistes, que certains lecteurs peuvent trouver sensibles. Les modèles de langage comme ChatGPT sont entraînés sur de grandes quantités de texte qui peuvent contenir un langage obsolète ou offensant. Il est recommandé de consulter les communautés appropriées pour obtenir des conseils sur l’utilisation respectueuse du langage.]
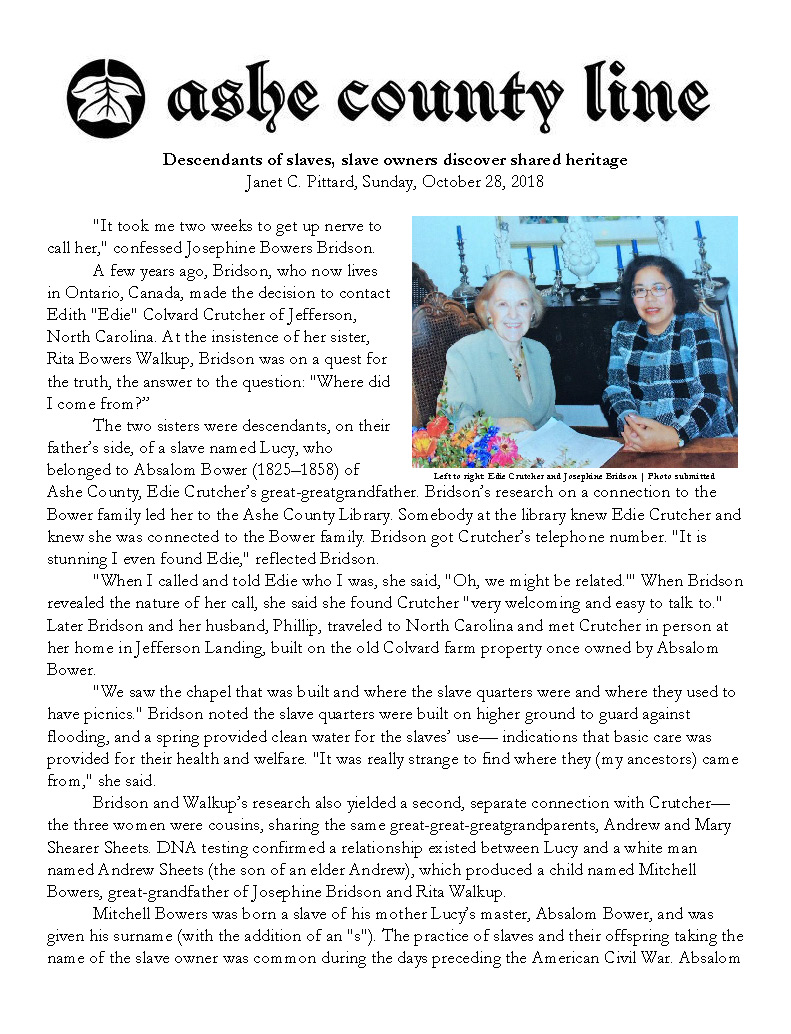
Notre dernier exemple concerne un article de journal riche en termes généalogiques. Il y a quelques années, des cousins ont découvert une ascendance commune. En tant que descendants d’esclaves et de leurs esclavagistes, les preuves ADN et les sources documentaires ont révélé leur héritage entrelacé. Une généalogiste et écrivaine locale, Janet Pittard, a écrit un article décrivant comment ces descendants d’esclaves et de propriétaires d’esclaves ont reconnu leur passé complexe pour cultiver de nouveaux liens. Je suis apparenté à tous ces gens. Mais la première fois que j’ai lu l’article, c’était un peu un défi de garder les relations claires dans mon esprit.
Aider à rendre clair et dense le texte généalogique est une tâche pour laquelle l’IA sera utile. Deux invites ont pu créer plusieurs tableaux et graphiques montrant les relations et les événements de l’article, ce qui les rend faciles à voir et à comprendre.
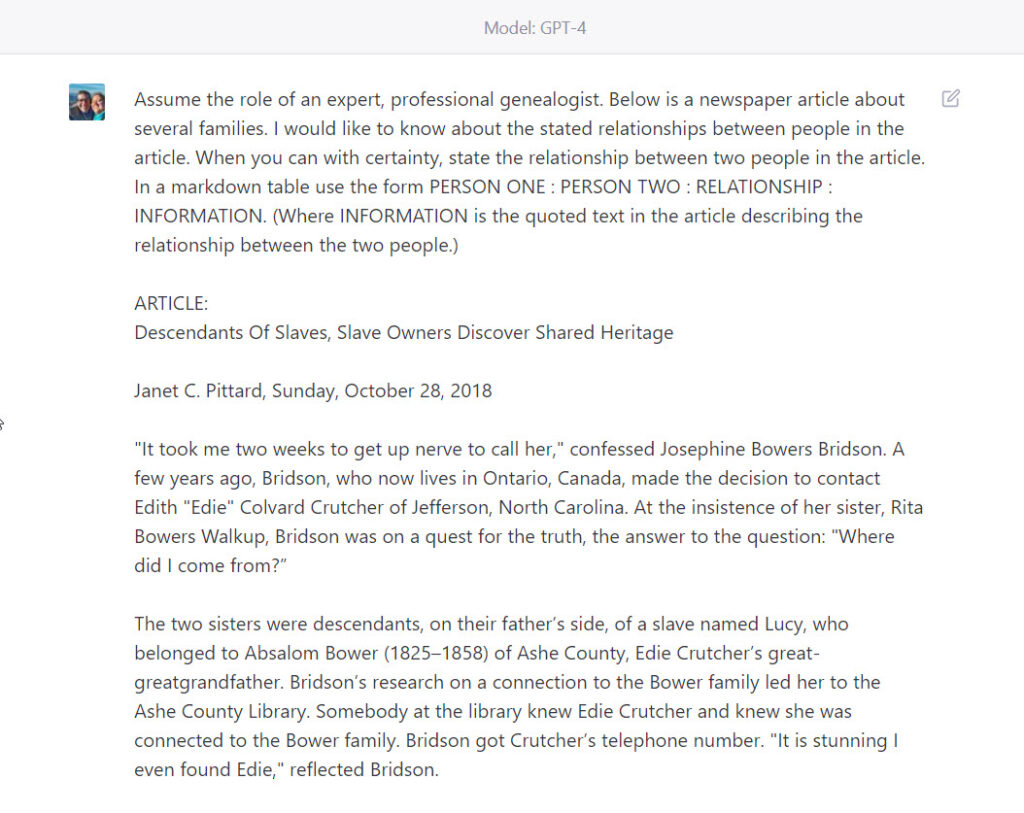
Avec un peu moins de 2000 mots, l’article était assez court pour la limite de saisie d’aujourd’hui. Mon invite initiale était similaire à celle que j’ai utilisée avec la nécrologie et l’annonce de mariage.
PROMPT: Assume the role of an expert, professional genealogist. Below is a newspaper article about several families. I would like to know about the stated relationships between people in the article. When you can with certainty, state the relationship between two people in the article. In a markdown table use the form PERSON ONE : PERSON TWO : RELATIONSHIP : INFORMATION. (Where INFORMATION is the quoted text in the article describing the relationship between the two people.)
Cette capture d’écran de l’invite montre comment je demande que les résultats de la relation soient affichés dans un tableau Markdown et que je montre le début de l’article dans la boîte de dialogue de discussion.
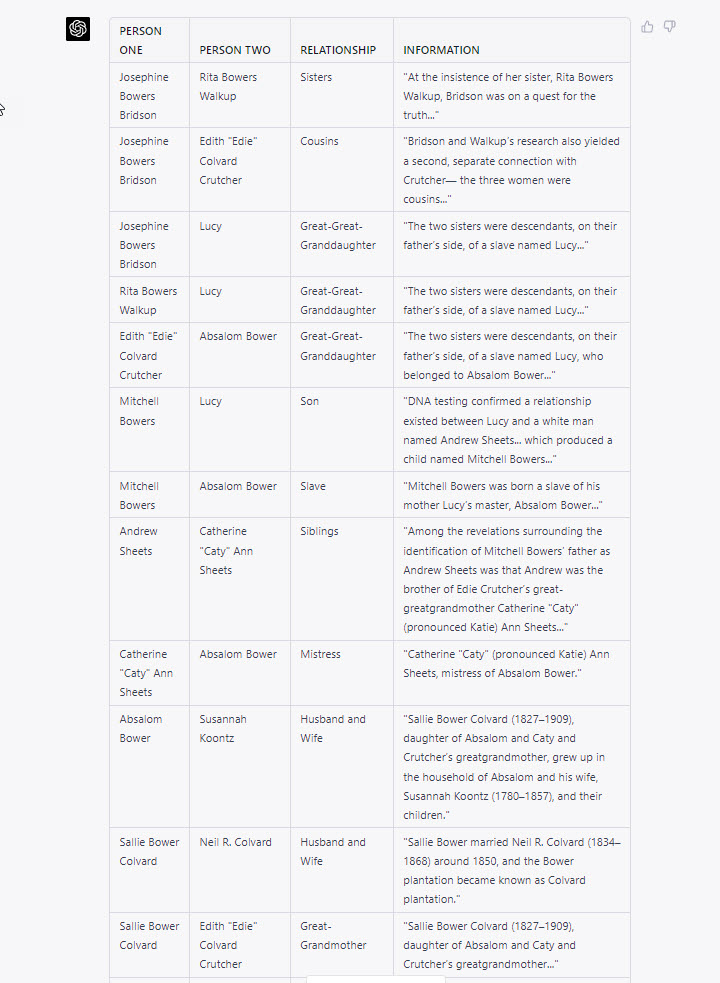
ChatGPT (modèle GPT-4) a répondu avec cette table Markdown (capture d’écran). Encore une fois, les résultats auraient également pu être rendus sous la forme d’un fichier d’arbre généalogique (GEDCOM), d’une feuille de calcul ou d’un fichier de base de données (CSV), ou d’autres formats de texte, tels qu’un JSON pour un traitement informatique ultérieur, ou sous forme de résumé narratif et abrégé des relations.
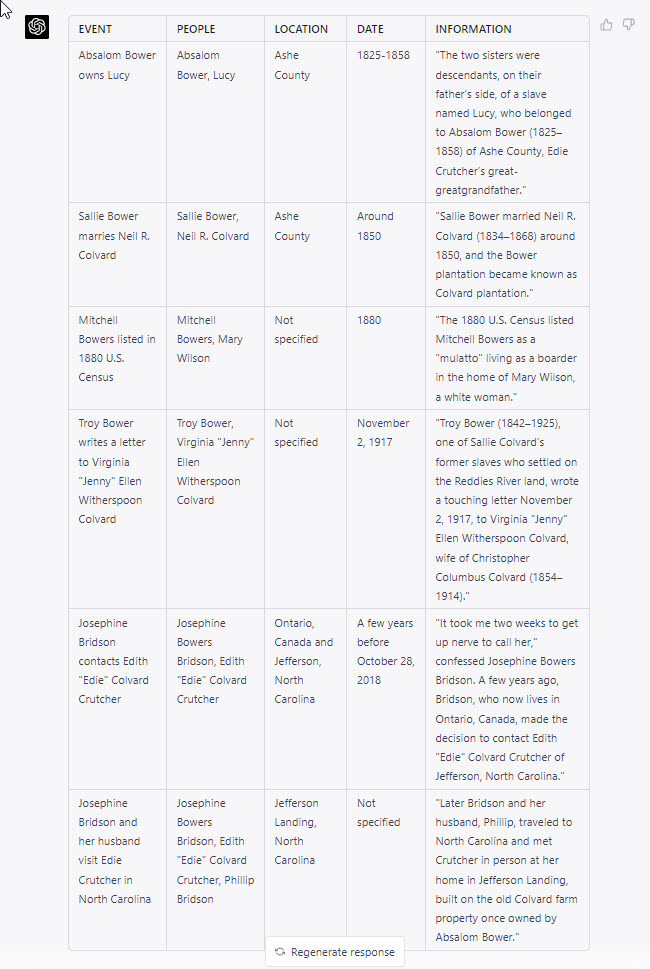
Cette dernière question était nouvelle. J’étais curieux de savoir si ChatGPT pouvait extraire une liste chronologique des événements dans l’article, trier la liste de l’événement le plus ancien à l’événement le plus récent, et inclure les personnes actives dans l’événement, le lieu de l’événement et le texte cité de l’article mentionnant l’événement. ChatGPT a été le plus souvent couronné de succès. La seule erreur que j’ai remarquée était de mal comprendre une durée de vie comme la plage de dates d’un événement ; c’est-à-dire, sur la première rangée d’événements, les dates de naissance et de mort d’Absalom Bower (1825-1858) ont, je pense, été incorrectement enregistrées comme les dates auxquelles Lucy a été réduite en esclavage par Bower. La signification et la signification de cette erreur méritent peut-être d’être testées et examinées plus avant.
L’invite, malgré cette erreur, a tout de même bien fonctionné, générant un tableau de cinq autres événements mentionnés dans l’article. ChatGPT a également réussi à trier correctement les événements par ordre chronologique, du plus ancien au plus récent. J’ai été quelque peu surpris par ce succès, car une faiblesse notoire avec les mathématiques de base a été observée dans les modèles GPT précédents.
Voici l’invite que j’ai conçue pour générer la table des événements à partir du texte généalogiquement riche :
PROMPT: Create a markdown table of events in the article; use the form:
EVENT | PEOPLE | LOCATION | DATE | INFORMATION
(Where INFORMATION is the quoted text from the article describing the noted event.)
(Sort the table chronologically by date, from oldest to newest.)
En conclusion, l’intelligence artificielle, en particulier ChatGPT (modèle GPT-4), offre un moyen efficace et innovant d’extraire des informations généalogiques de diverses sources textuelles telles que les nécrologies, les annonces de mariage et les articles de journaux. En utilisant des invites soigneusement conçues, les utilisateurs peuvent demander à l’IA d’interpréter et de résumer les relations, les événements et d’autres informations pertinentes dans une variété de formats, y compris des tables Markdown, des fichiers GEDCOM et des fichiers CSV. Cela permet aux chercheurs de recueillir et de stocker rapidement des informations provenant de sources pour une analyse et une application plus approfondies.
Bien que ChatGPT ait permis aux utilisateurs sans compétences avancées en linguistique informatique d’effectuer ces tâches, il est essentiel d’aborder le processus de manière réfléchie, en élaborant soigneusement des invites et en vérifiant les résultats de l’IA. De plus, il est essentiel de démarrer de nouvelles sessions de chat ou conversations pour chaque nouvelle source de texte afin d’éviter la contamination du traitement de l’IA.
Au fur et à mesure que l’IA progresse, nous pouvons nous attendre à de nouvelles améliorations de ses capacités, ce qui la rend encore plus précieuse pour la recherche généalogique et d’autres domaines qui nécessitent l’extraction d’informations pertinentes à partir de grands volumes de texte.
Publié par Steve Little
Steve Little est le directeur du programme d’IA de la National Genealogical Society et le fondateur d’AI Genealogy Insights. Mes racines profondes remontent à un comté des Appalaches, où, en 1820, mes 32 arrière-grands-parents s’étaient installés, beaucoup même avant cela. En fait, 60 de mes ancêtres les plus récents sont nés, ont vécu et sont morts là-bas, dans le comté d’Ashe, en Caroline du Nord. Ma passion réside dans l’IA et la généalogie génétique : avec un vif intérêt pour l’endogamie, l’effondrement du pedigree et l’art de déchiffrer de multiples relations par triangulation de segments d’ADN, et une curiosité insatiable pour explorer les utilisations bénéfiques et les limites actuelles de l’intelligence artificielle en généalogie. Au-delà de la généalogie, je porte plusieurs casquettes : je suis un mari et un père, un pasteur méthodiste et un Virginien. Mes passe-temps vont de l’observation des oiseaux et du ciel aux échecs et au cinéma. De plus, je suis un lecteur passionné, un écrivain, un photographe et un hacker de script regex. Voir tous les articles de Steve Little
Publié
4 réflexions sur « IA et généalogie : utiliser ChatGPT pour glaner des informations à partir d’obits, d’articles et d’annonces »




4 réflexions sur « IA et généalogie : utiliser ChatGPT pour glaner des informations à partir d’obits, d’articles et d’annonces »